客户简介
吉因加
吉因加聚焦肿瘤精准防治大需求,依托高通量测序与高性能计算大平台,通过肿瘤基因大数据挖掘,提供科研合作、技术开发与产品转化、临床检测与医学健康等服务,推动基因技术服务人人,实现“基因科技,维护健康”的愿景。
案例描述
初期,荣联科技集团在用户本地以绿色数据中心为理念,为测序仪下线数据提供计算以及存储资源。存储系统需要存放基因原始数据、实验过程数据、结果数据及其他一些用途的文件和程序。数据流能在多个工作组之间共享,存储读写能力要满足几十个计算节点的频繁访问,存储系统一定是可靠的、可用的,不间断持续提供存储服务。
考虑到传统存储技术SAN、NAS主要为高级别事务的结构化数据和相对来说轻量级文件数量设计的,支持scale-up纵向扩展或有限的scale-out横向扩展。尤其是海量的非结构化数据爆发式的增长,容量与性能线性扩展与缺乏灵活性的传统存储越来越难于匹配,成为不可逾越的鸿沟。
我们使用生物数据平台组建客户IT机房的存储系统。该数据平台系统融合了横向扩展与纵向扩展技术特点于一体,以非常灵活的方式实现存储管理、数据地址空间、命名空间、数据可靠性与可用性。
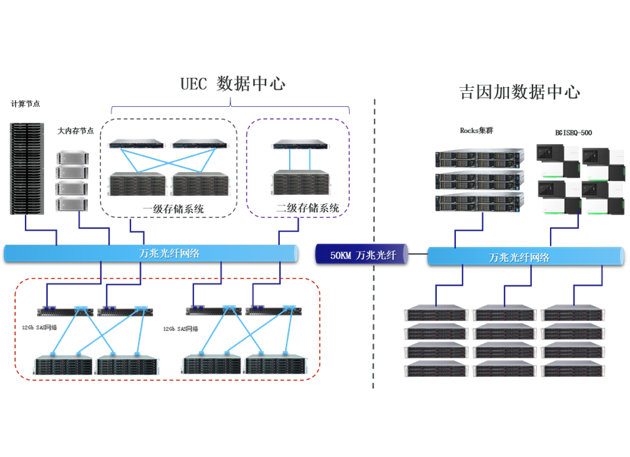
基于10Gb万兆网络与计算节点互联,用于数据频繁读写和数据共享。存储系统1Gb千兆与测序设备互联,实现原始数据上传和数据共享。
生物数据平台在吉因加先后完成四期动态扩容,真正的实现了按需建设,这时,用户也面临了另一大难题——本地数据中心空间不足。而同期酒仙桥生物云数据中心的建成为用户解决了这一问题,吉因加将后续扩容的计算及存储设备托管在生物云IDC,另外提供了到用户本地的万兆裸光纤,实现整个生产系统无缝对接,用户使用与本地无差别。最终提供近5PB的数据空间,满足上百个计算节点的访问和数据共享。在整个生物数据分析流程业务中,支撑分析计算的快速实现和完成,满足实效性,提高生产效率。
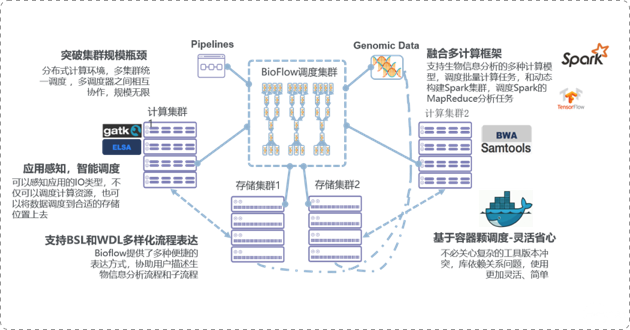
与此同时,通过部署生物数据平台不但实现了对海量生物数据的高效存取,同时平台强大的数据管理系统对大规模复杂的生物数据实现了有效管理,而借助Bioflow计算系统助力吉因加实现了跨多个计算集群、存储集群的生物信息分析的作业任务调度。
Bioflow计算系统通过为生物信息设计的资源调度和分析计算引擎,灵活高效的组织生物信息分析流程、调度生物信息作业。
采用分布式的调度器设计,多调度器实例、多调度队列相互协作,负载均衡。能够联合多个计算集群的计算资源,形成统一的调度空间,从根本上避免单个集群的规模瓶颈和单一调度器在多任务并发请求时自身的瓶颈。
客户收益
1)完成数据中心存储系统的建设,大容量存储池,上千任务投递时对存储资源的访问需求,动态扩展,自动化分析流程中,缩短分析周期,提高生产效率,满足生产和科研的业务发展。
2)生物数据平台,全面解决了用户计算环境所面临的各种挑战:海量数据存储;海量数据管理与发现;高效的多集群计算与调度
方案价值
通过平台中数据操作系统的协助,吉因加3年内轻松透明的从 20TB 数据扩展到了现在的 8PB 数据。
吉因加今天在4个地点的数据中心部署了数据操作系统,并且每天在 Biostack上存储,管理和处理着 8PB 核心生物信息数据。
吉因加正在构建自己的测序中心,并且计划在1年内将原有的48个节点的Bioflow集群扩展到100节点BioFlow计算集群,数据存储规模将达到15PB;预计在2年内将会达到300计算节点,25PB
数据存储的规模。
使用平台中Metaview之后, 吉因加可以在1 秒内从59,407,376 个文件, 4,706,567
目录中根据标签或名字快速发现任意指定数据,甚至瞬间重组整个数据的层级和组合关系,以展现新的数据视图。


 京公网安备 11010502047193 号